对话中上传文件与图片:让回答基于真实内容
把真实材料丢给 AI,回答质量立刻上一个台阶——不再依赖模型的泛泛记忆。这页讲上传的正确姿势。
上传入口
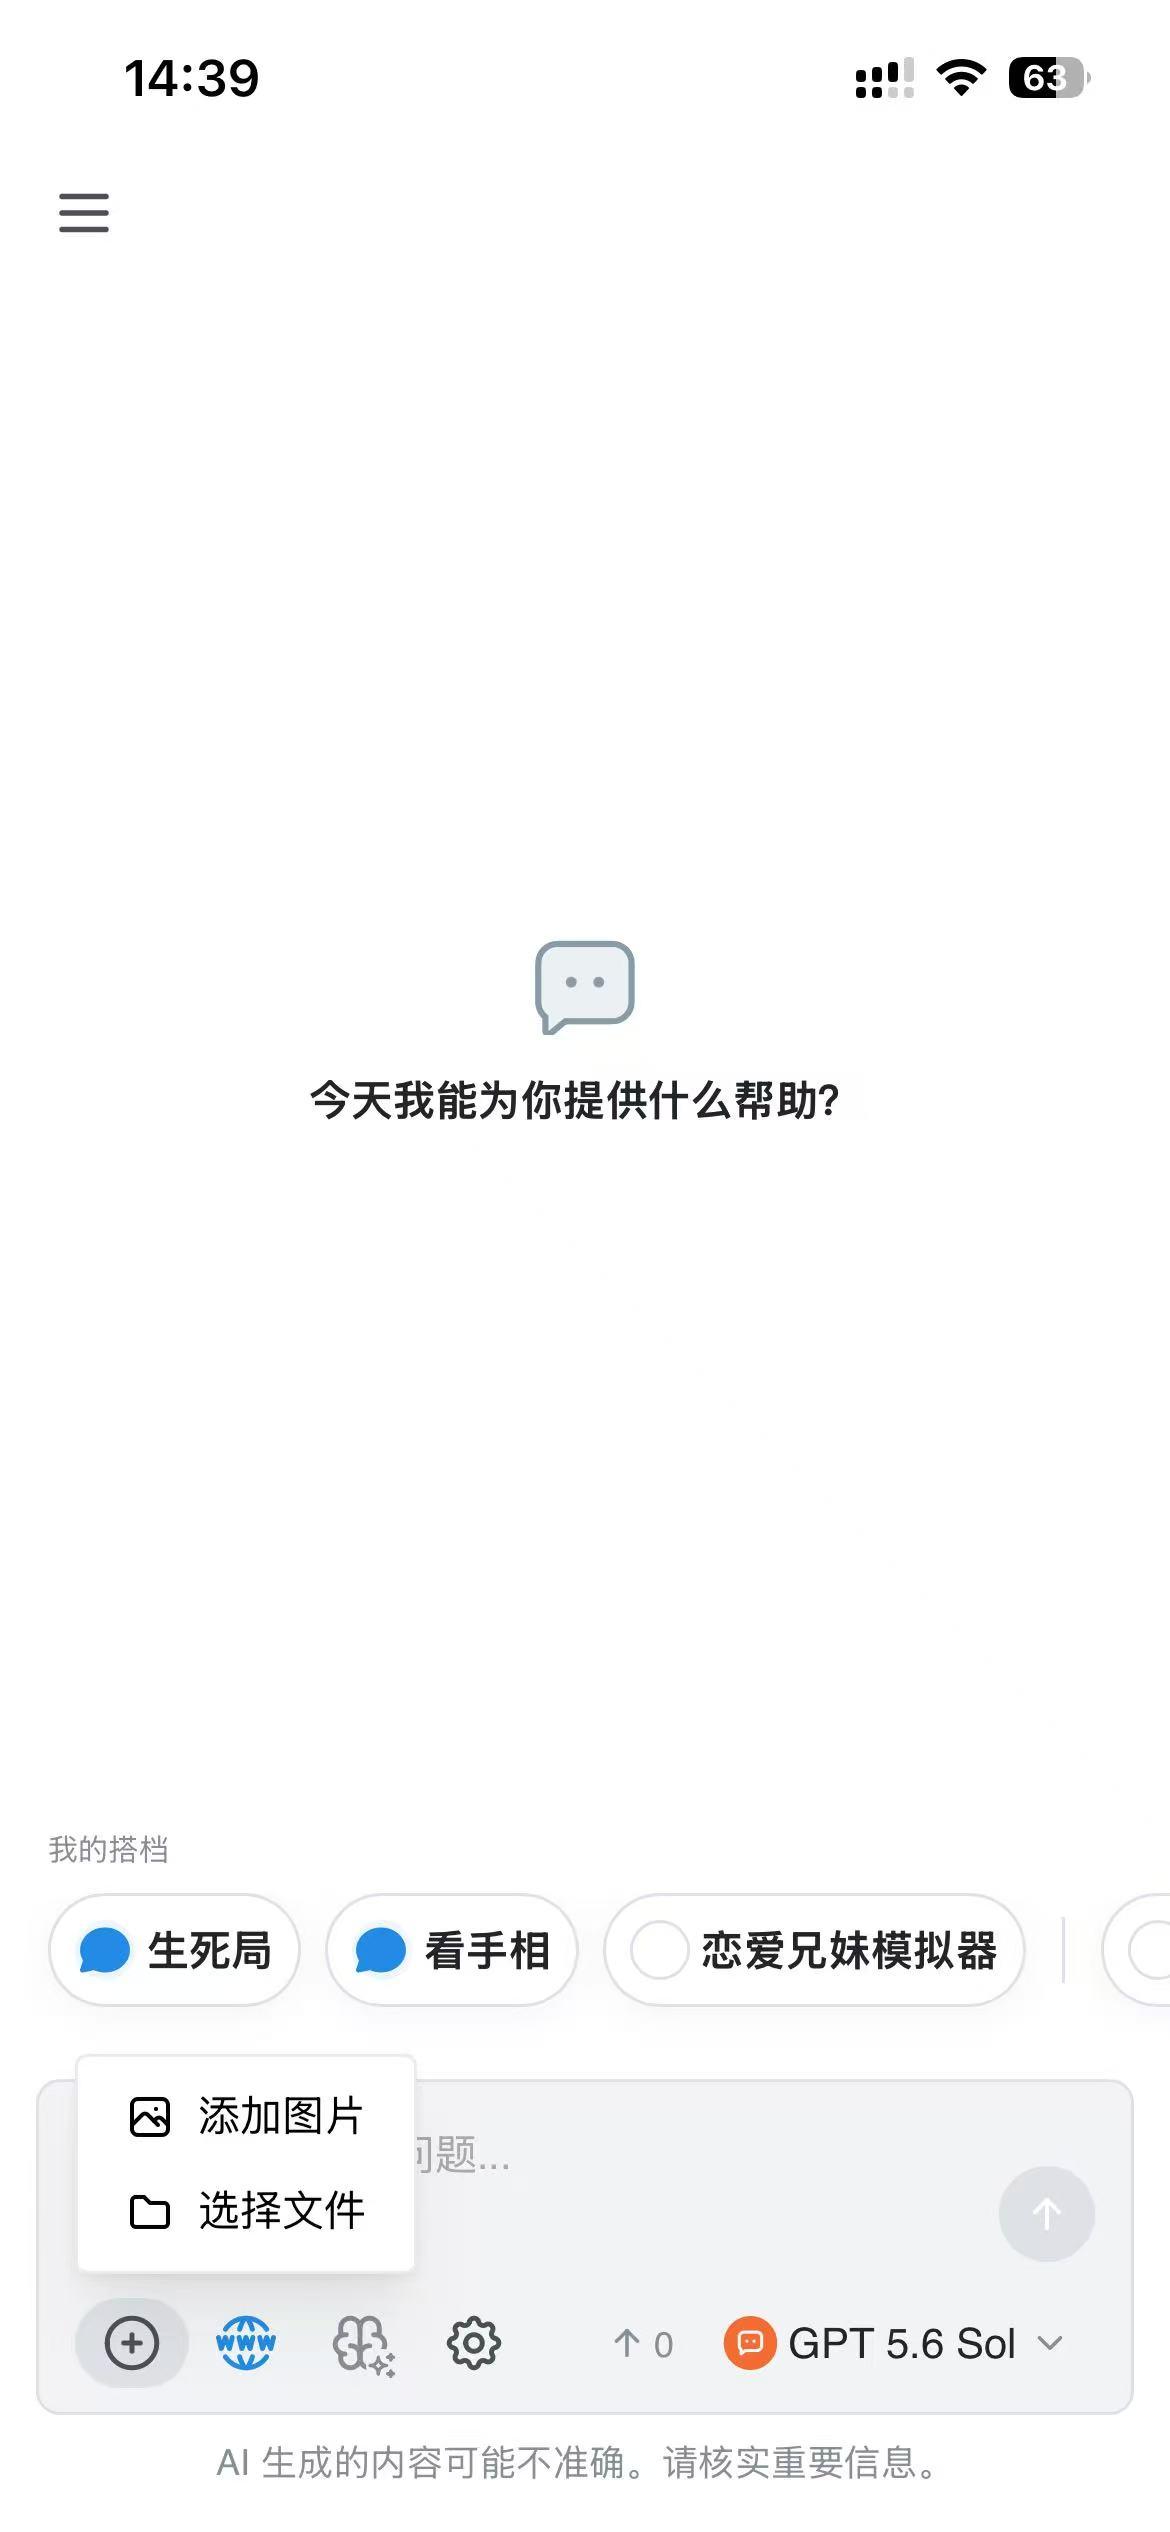
输入框左下角的「+」号,四种方式:
- 文件——文档、表格、代码文件等
- 图片——截图、照片、图表
- 链接——给一个网页地址让 AI 读取(配合联网能力)
- 拍照——移动端直接拍,桌面端用图片方式替代
关键:选对模型
上传后能吃下什么,取决于所选模型:
| 上传内容 | 模型要求 |
|---|---|
| 纯文本文档 | 任意模型 |
| 图片理解 | 必须是支持视觉的模型 |
| 复杂表格 / 长文档 | 上下文窗口大的模型更稳 |
传完图发现 AI 说"看不到图片",九成是模型不支持视觉——右下角换模型再试。
实用技巧
- 大文档:几十页的材料建议开新对话再传,避免与旧上下文挤在一起(见上下文管理)
- 多文件对比:一次传齐再问"对比这三份方案的差异",比逐份问效果好
- 说明意图:别只扔文件,加一句"重点看第三章的预算部分",检索更准
- 格式类任务:表格数据要计算或转换的,直接上工作模式,让它跑代码处理
一次性上传与知识库的选择
这页讲的是临时上传:本次对话用完即止。资料要长期反复查询的,入库才是正解,对比表见知识库概念。
上传内容会随请求发送给所选模型服务商,敏感材料的接入方式参考隐私边界。